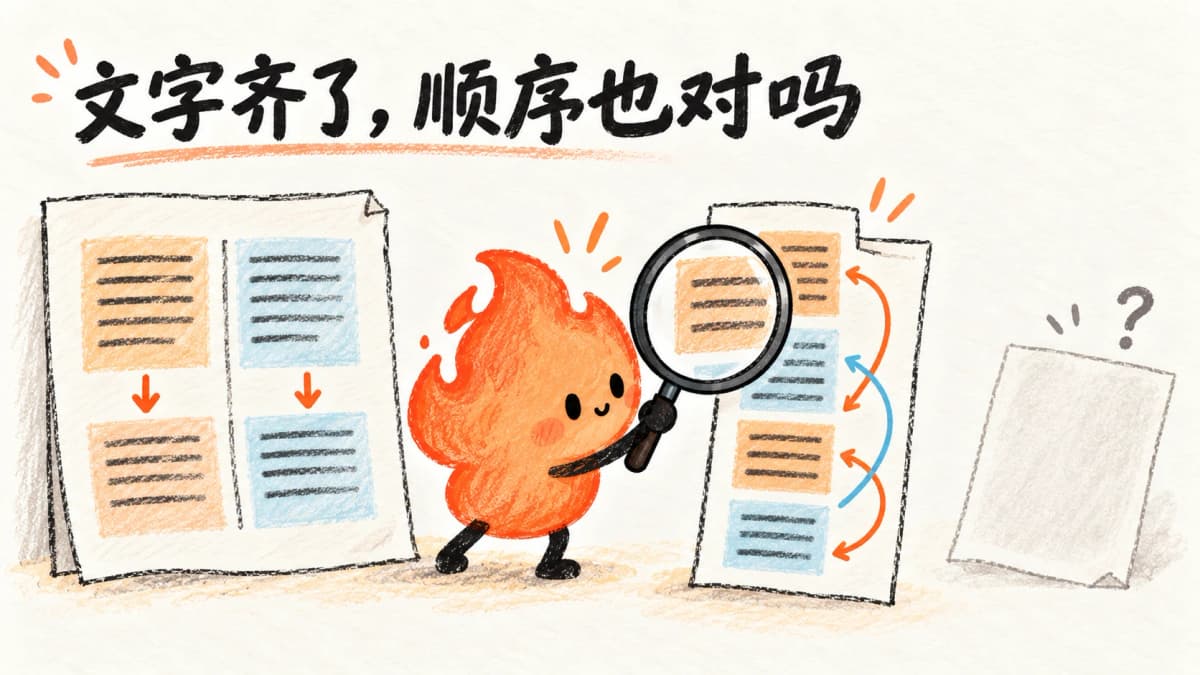
AI 生成的小火人手绘概念插画,用于概括文章观点;不是产品截图或实测证据。
PDF 转出文字就算成功吗?五份样本揭示顺序与漏页问题
实际比较 MarkItDown、pypdf 和 PyMuPDF 的五份自制 PDF 输出:文字齐全不代表阅读顺序正确,非空结果也可能漏掉扫描页。附样本、原始输出和核对标准。
阅读依据 · 本地功能试验
2026-10-16 (Asia/Shanghai) · MarkItDown 0.1.8 / pypdf 6.21.0 / PyMuPDF 1.28.2 / Python 3.12.13
Windows 11、隔离 Python 环境;没有 OCR 服务或 LLM,PyMuPDF 使用排序后的纯文本提取。
三个解析器处理同样五份自制 PDF;保留十五份原始输出,核对字段、表格对应、双栏顺序与图像页遗漏。
小型英文样本,不代表总体准确率;未测 OCR、结构化单元格、Docling 或 MinerU。在本设置下三个解析器都漏掉图像内容。
试验仅代表上述范围的实际观察,不是产品认证或全面质量结论。
把 PDF 转成文字,通常是做知识库、整理资料或交给 AI 阅读的第一步。最容易忽略的错误却发生在这一步:文件已经生成,文字看起来也不少,但步骤顺序变了,或者整张扫描页根本没有进入结果。
我们在 Windows 11、Python 3.12.13 的独立环境中,实际处理了五份自制英文 PDF。使用 MarkItDown 0.1.8、pypdf 6.21.0,以及 PyMuPDF 1.28.2 的 sort=True 文字提取。没有启用 OCR、模型服务或联网识别。这里比较的是这三种具体配置的输出,不是所有文档解析产品的排名;Docling、MinerU 没有参与本次运行。
先下载一份文件,再看提取结果
不用安装任何软件,也可以核对这个实验。下载样本与输出包,先打开 columns.pdf,按页面要求阅读:左栏从上到下,再读右栏。预期是 STEP-1、STEP-2、STEP-3、STEP-4。
然后打开同名的三个 .txt 输出。MarkItDown 变成了 1、3、2、4;pypdf 按这份 PDF 的内容写入顺序输出为 3、4、1、2;PyMuPDF 的排序输出在同一行摆放左右栏,线性阅读仍是 1、3、2、4。四个标签都在,却没有一个满足预先声明的按列顺序。
这不是说 PDF 只能有一种正确阅读方式。实验专门在页面顶部写明了本例的顺序要求,也故意先写入右栏内容,让“文件内部顺序”和“读者应当阅读的顺序”不同。它是可复现的边界样本,不代表普通文件中有多大比例会出错。
五份样本分别说明什么
| 样本 | MarkItDown | pypdf | PyMuPDF,排序提取 |
|---|---|---|---|
| 普通文字制度 | 三个预设字段都保留 | 三个字段都保留 | 三个字段都保留 |
| 两行产品价格表 | 型号和金额都在,但线性输出未保留行配对 | 型号和金额都在,按列写入顺序出现 | 文本空格保留了较易阅读的行对齐,但不是结构化单元格 |
| 两栏步骤 | 字段齐全,顺序不符合本例要求 | 字段齐全,顺序不符合本例要求 | 字段齐全,线性顺序不符合本例要求 |
| 纯图像页 | 输出为空 | 输出为空 | 输出为空 |
| 文字页加图像页 | 留下第一页,漏掉第二页两个字段 | 同样漏掉图像页字段 | 同样漏掉图像页字段 |
所有十五次转换调用都正常返回,没有抛出异常。运行没有报错,不等于文档任务完成。 完整结果 CSV同时记录输出字符数、缺失字段和适用时的顺序检查;字段齐全不是“整体通过”。
表格最容易给人错误的安全感
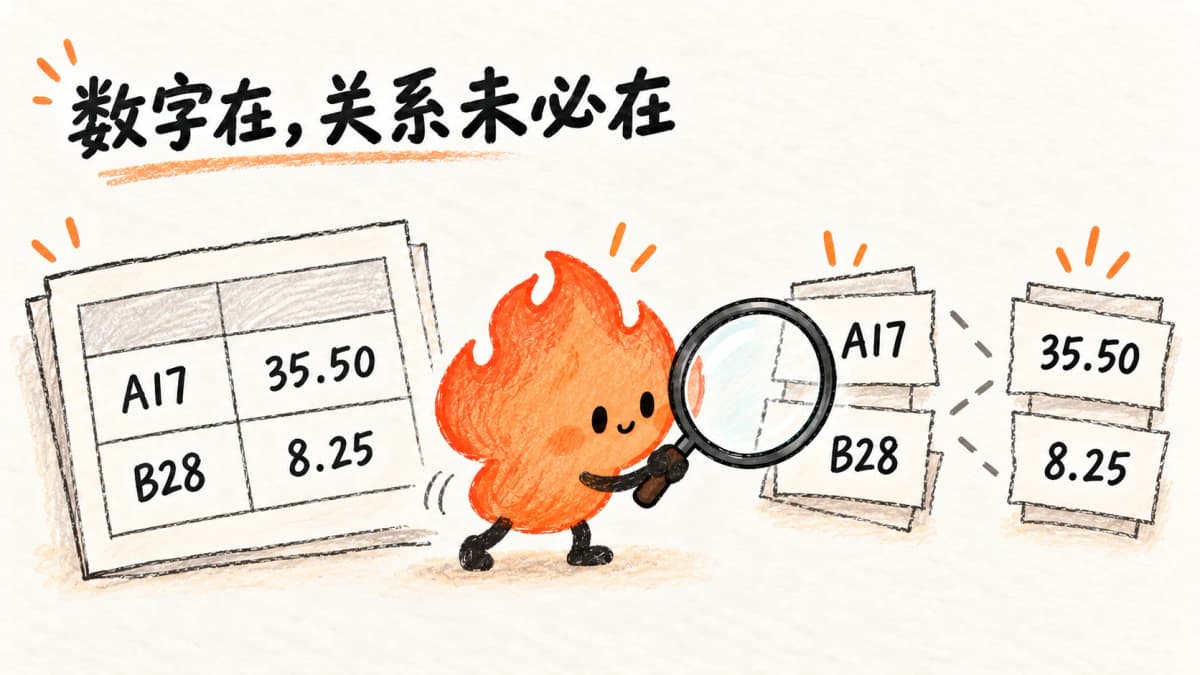
table.pdf 中,A17 对应 35.50,B28 对应 8.25。MarkItDown 的输出里,两行型号连续出现,两行金额也连续出现。搜索 A17 或 35.50 都能找到,但只确认数字存在,无法证明后续系统会正确关联它们。
PyMuPDF 的排序文本在这个简单样本中保留了较清晰的行间对齐。然而,这依然是带空格的文本,不是已经验证好行列关系的数据库。把它再交给模型重新排版,可能引入另一层错误。对于发票、报价或库存表,验收对象应当是“这一行的产品、数量与金额是否对应”,而不是“文件里有几个数字”。本实验没有测试合并单元格、跨页表格或真实发票准确率。
为什么扫描页会悄悄消失
纯图像样本里的文字被绘制成了一张图片,没有可提取的文字层。三个配置都没有运行 OCR,因此空结果符合它们的处理边界。pypdf 官方说明明确区分文字提取和 OCR;PyMuPDF 文档也解释了原始顺序与排序提取的差别。
更危险的是 mixed.pdf:第一张文字页让输出看起来有内容,第二张图像页的 PAGE-TWO 和 73.25 却都缺失。只检查结果非空,无法发现漏页。这里不能推导出“工具不支持 OCR”;只能说本次未启用 OCR 的路径没有读到图片中的文字。加入 OCR 后是否识别正确,需要另一组明确的语言、图片质量和字段测试。
普通人可以怎样验收自己的资料
先选一份低敏感、有代表性的文件,不要第一次就上传整个资料库。预先记下几个你知道的关键点:一行表格的对应关系、一句否定表达、两个相邻步骤,以及最后一页的内容。
打开转换结果,逐项定位这些内容。不要要求 AI “自己判断有没有漏字”后就接受结论;它可能同样没有读到漏掉的页面。发现图像页没有文字后,再决定是否采用 OCR,并用原页核对金额、日期和姓名。
若请 Codex 或 Claude 协助,可以这样明确任务:
只使用这份公开测试 PDF。记录转换器版本和是否启用 OCR。保留未经改写的输出,对照我提供的字段与阅读顺序检查缺失。不要把运行完成、结果非空或字段齐全当成整体通过,也不要替我修补原文不存在的内容。
如何选择下一步,而不是选择一个“冠军”
如果资料本身是普通文字,当前样本没有提供足够理由宣布某个引擎更准确;可以优先考虑安装负担和现有流程。MarkItDown 的价值还包括多格式转 Markdown,不应只用 PDF 文字提取与专门 PDF 库比较全部能力。完整 MarkItDown 分析说明了它的适用范围。
如果任务依赖阅读顺序、表格结构或图像文字,应该寻找对应的解析能力,再用相同文件验证。不能把未执行的 Docling、MinerU 或 OCR 服务填进这张表,假定它们一定解决了问题。更不能把五份合成英文文件的表现写成对中文合同或生产资料的准确率承诺。
本次可下载的输入由 Git-Stars 制作,不含真实业务数据;输出保留了错误,没有人工整理成漂亮的“正确答案”。方法与复现说明列出确切配置、预设标准及如何读结果。后续做文档问答前,可以先读来源、版本与引文核对实验:上游没读到的内容,下游模型不应该替它编出来。
作者
分类
继续解决你的问题
邮件列表
加入我们的社区
订阅邮件列表,及时获取最新消息和更新